Table des matières :
- Messenger en production : ce que le framework ne vous garantit pas
- Socle de configuration : routing, sérialisation, retries, échecs
- RabbitMQ (AMQP) : topologie, QoS, HA, délais, TLS
- Redis (Streams) : quand la simplicité devient une contrainte
- Amazon SQS : file managée, contraintes de visibilité et design FIFO
- Exploitation : workers, scaling, observabilité, et cas PrestaShop
Messenger en production : ce que le framework ne vous garantit pas
Symfony Messenger est un bus de messages avec une abstraction de transport. En dev, on démarre souvent avec sync:// ou doctrine:// et tout “marche”. En production, ce n’est plus un sujet d’API Symfony mais d’ingénierie de file : durabilité, latence P95/P99, garanties de livraison (souvent au moins une fois), pression de back-pressure, redélivrance, gestion des “poison messages”, et surtout observabilité.
Un point à intégrer tout de suite : Messenger ne rend pas un traitement « exactly-once ». Les transports de queue imposent des compromis (redelivery, ack tardif, timeouts), et c’est à vos handlers d’être idempotents (ou au minimum de détecter les doublons). Si vous publiez un message “envoi facture”, attendez‑vous à ce qu’il soit traité deux fois dans certains scénarios (crash worker après effet de bord mais avant ack, timeout réseau, visibilité SQS expirée, etc.).
Pour rendre l’idempotence opérationnelle (et pas juste “une intention”), vous avez généralement 3 options, à combiner selon le cas :
- Verrou / déduplication applicative : stocker un
idempotency_key(oumessage_id) en base avec contrainte d’unicité, et “no-op” si déjà vu. - Effet de bord transactionnel : quand c’est possible, encapsuler l’effet (écriture DB) + marqueur “traité” dans la même transaction.
- Outbox / inbox : persister l’événement à publier (outbox) ou l’événement consommé (inbox) et traiter de façon déterministe. C’est souvent ce qui évite les “demi-effets” quand vous avez DB + API externe.
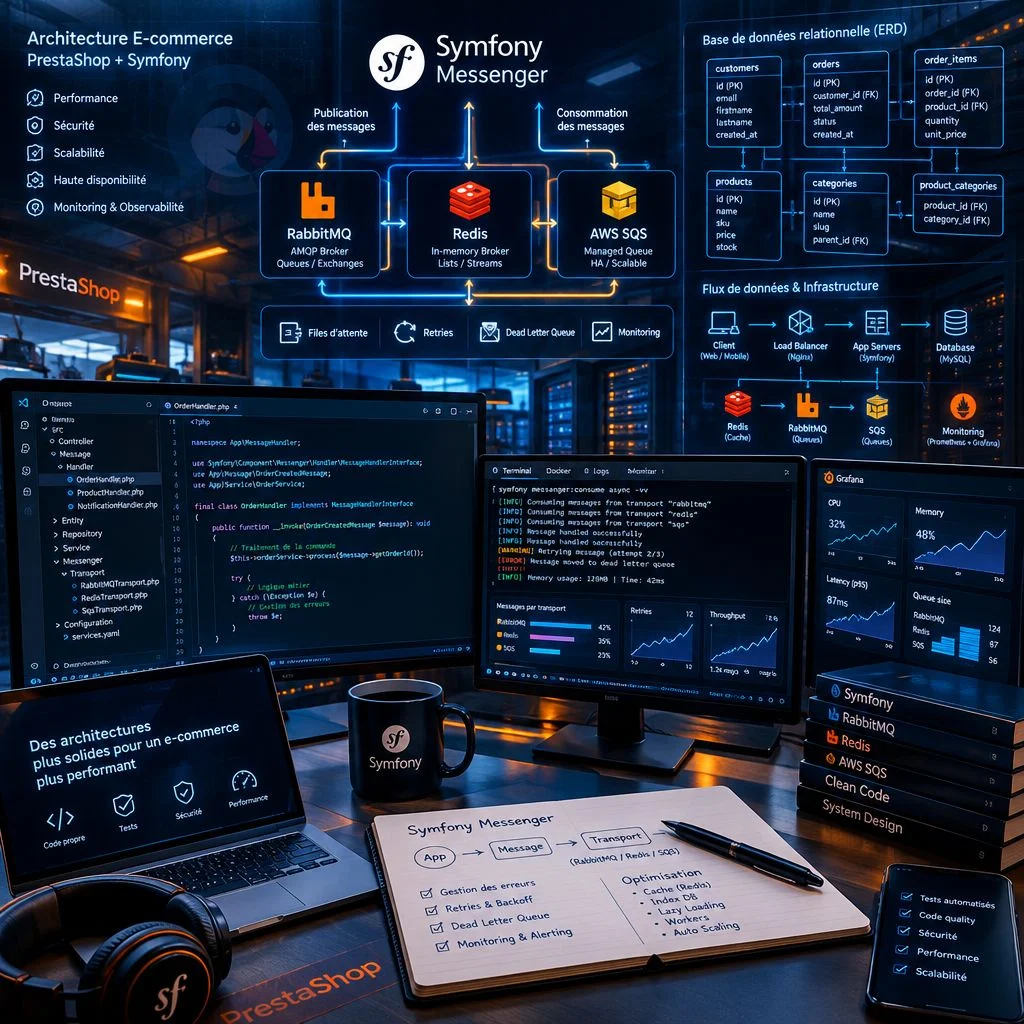
Le choix RabbitMQ vs Redis vs SQS se joue rarement sur « performance brute » uniquement. Il se joue sur : (1) votre modèle d’exploitation (self‑hosted vs managé), (2) votre besoin de topologies (routing, DLX), (3) vos contraintes réseau (TLS, cross‑AZ / multi‑DC), et (4) votre capacité à instrumenter les workers. Le principe Twelve‑Factor s’applique bien ici :
“Treat backing services as attached resources.” — The Twelve‑Factor App, chapitre “Backing services” (https://12factor.net/backing-services)
Pour cadrer rapidement, voici une grille de lecture utile en e‑commerce (volontairement simplifiée) :
| Transport | Points forts | Contraintes typiques | Quand c’est un bon choix |
|---|---|---|---|
| RabbitMQ (AMQP) | routing/exchanges, DLX, contrôle fin consommateurs | broker stateful à opérer, HA à tester, quotas disque | besoin de topologies et de pilotage fin (priorités, routage) |
| Redis Streams | latence faible, simple si Redis déjà là | mémoire/PEL, persistance à assumer (AOF/RDB), moins de routing | petites/moyennes files, équipe déjà “Redis‑mature” |
| Amazon SQS | managé, IAM, DLQ, scaling simple | visibilité, limites payload 256 KB, moins de topologies | “ops minimal”, workloads asynchrones standards, multi‑AZ natif |
Dans l’écosystème PrestaShop (1.7 → 9.x), ça arrive typiquement quand vous voulez sortir du “cron + script” pour du traitement asynchrone robuste (imports, webhooks, enrichissement catalogue, sync ERP). Et vous vous heurtez vite aux problèmes classiques d’exploitation : workers qui meurent, mémoire qui grimpe, erreurs 503 si vous faites du traitement lourd dans le cycle HTTP. Pour les symptômes côté boutique, gardez sous la main vos procédures de triage (ex. 503 : diagnostiquer PHP et les logs Apache/LiteSpeed).
Socle de configuration : routing, sérialisation, retries, échecs
Sur Symfony 6.4 LTS (très courant en e‑commerce) et Symfony 7.x, la configuration de base se structure autour de : transports, routing, failure transport et retry strategy. L’objectif en production est d’avoir (a) un transport “async” principal, (b) un transport “failed” qui capture tout ce qui a dépassé la politique de retry, et (c) des stratégies différenciées par type de message (un paiement ne se “retry” pas comme un cache warmup).
Exemple minimaliste mais exploitable (YAML), avec sérialisation JSON, routing explicite, et file d’échecs. Adaptez les DSN via variables d’environnement (et pas dans le dépôt) — si vous avez déjà dû dépanner var/cache ou des variables d’environnement mal injectées, vous voyez le genre (cf. dépannage erreurs 500 / cache / env).
# config/packages/messenger.yaml
framework:
  messenger:
    failure_transport: failed

    transports:
      async:
        dsn: '%env(MESSENGER_TRANSPORT_DSN)%'
        serializer: messenger.transport.symfony_serializer
        retry_strategy:
          max_retries: 5
          delay: 1000       # ms
          multiplier: 2
          max_delay: 60000

      failed:
        dsn: '%env(MESSENGER_FAILURE_TRANSPORT_DSN)%'

    routing:
      App\Message\SyncErpCommand: async
      App\Message\ReindexProductCommand: async
Quelques points de prod qui font vraiment la différence :
- Serializer : rester sur JSON (ou un format stable) facilite le debug et limite les surprises lors de déploiements. Évitez les messages qui sérialisent des entités Doctrine complètes : vous allez créer du couplage, des payloads lourds, et des incompatibilités à la moindre évolution.
- Versioning : pour des systèmes distribués, prévoyez tôt un champ
schema_versionou des messages “V1/V2” (même si vous n’en avez pas besoin au jour 1). Ça évite de casser une file lors d’un déploiement partiel. - Retry par catégorie : si certaines classes doivent échouer vite (ex. validation) alors que d’autres doivent retry longtemps (ex. endpoint ERP instable), vous pouvez segmenter en plusieurs transports (par ex.
async_fast,async_slow) et router par message.
Le piège classique en prod : envoyer des payloads volumineux (objets complets, HTML, exports) plutôt que des identifiants. Les transports ont des limites (SQS 256 KB, Redis mémoire, RabbitMQ pression disque) et le couplage de votre message à votre modèle de données explose dès qu’une entité évolue. Modèle sain : message = intention + identifiant + métadonnées, et le handler recharge l’état nécessaire (avec garde‑fous). Pour un e‑commerce, corrélez toujours le message à un order_id, shop_id, idempotency_key, et si possible un correlation_id (pour relier HTTP → dispatch → consommation).
Mini‑scénario concret (type PrestaShop) : vous recevez une commande, vous dispatchez SyncErpCommand(order_id=123, idempotency_key="erp:order:123:v1"). Si l’ERP time‑out, Messenger retry. Si le worker crashe juste après avoir créé la commande ERP mais avant l’ack, le message sera redélivré ; votre handler doit détecter que erp:order:123:v1 a déjà été traité (ou que l’ERP a déjà une référence) et sortir proprement.
Deux commandes à intégrer à votre runbook : messenger:failed:show / messenger:failed:retry pour rejouer (ou inspecter) et messenger:consume avec des limites (temps, mémoire) pour éviter les workers “immortels”. Ajoutez aussi messenger:stop-workers (arrêt gracieux lors d’un déploiement) pour éviter de tuer des processus en plein traitement.
En incident, c’est votre levier pour réduire la MTTR, à condition d’avoir de la télémétrie (logs structurés + traces). Sur ce point, les patterns de “santé des intégrations” décrits côté webhooks sont transposables aux files (voir observabilité et gestion de santé des connexions).
RabbitMQ (AMQP) : topologie, QoS, HA, délais, TLS
RabbitMQ est pertinent dès que vous avez besoin de topologies (exchange/queues/binding keys), de dead-lettering maîtrisé, et d’un pilotage fin des consommateurs (QoS/prefetch). C’est aussi un transport très robuste face aux pics, à condition de dimensionner disque/RAM et de comprendre les modes de queues (classiques vs quorum). En contrepartie, vous exploitez un broker stateful : sauvegardes, upgrades, et HA réellement testée (et pas “sur le papier”).
Côté Symfony, le transport AMQP s’appuie sur symfony/amqp-messenger (et l’extension AMQP ou php-amqplib selon votre stack). Configuration typique : échange durable, queue durable, et QoS pour limiter le nombre de messages “en vol” par worker (indispensable si un handler fait des appels réseau ou charge la base). Exemple :
framework:
  messenger:
    transports:
      async:
        dsn: '%env(MESSENGER_TRANSPORT_DSN)%' # amqp://user:pass@rabbit:5672/vhost
        options:
          exchange:
            name: app.messages
            type: direct
            durable: true
          queues:
            app.messages:
              binding_keys: ['app.messages']
              durable: true
          qos:
            prefetch_count: 10
En production, la valeur de prefetch_count est un levier direct sur (1) la latence de traitement, (2) la mémoire du worker, (3) la “fairness” entre workers. Un cas réel typique : un handler d’export ERP traite ~200–400 ms/message (HTTP + DB). Avec prefetch_count=50, vous allez avoir des workers qui stockent 50 messages en mémoire et retiennent des acks, ce qui augmente les redélivrances en cas de crash et rend la latence P99 erratique. Avec prefetch_count=5–10, vous acceptez un débit un peu plus stable et une récupération plus propre.
Pour les délais (delay) et retries, RabbitMQ vous permet de faire du dead-letter exchange (DLX) ou d’utiliser des plugins (x-delayed-message). Messenger gère des stratégies de “retry avec délai” en créant des files intermédiaires (selon config/transport). Deux recommandations “ops” qui évitent des surprises :
- Provisionnez la topologie (exchange/queues/DLX) via IaC quand votre environnement est verrouillé (droits restreints). Dans ce cas, mettez
auto_setup: falsecôté Symfony, sinon l’app tente de créer/modifier des ressources au runtime. - Choisissez explicitement le modèle HA : en RabbitMQ, les quorum queues sont souvent préférées pour la résilience (réplication, consensus) au prix de plus de coût. Si vous restez en classic queues, testez la panne d’un nœud en conditions réelles (redémarrage, partition réseau, disque plein).
Sécurité : utilisez amqps:// avec TLS, validez les certificats, et évitez les credentials statiques en clair. Sur un contexte UE/France, ça a un impact direct sur vos exigences de conformité (chiffrement en transit, gestion des secrets) et sur la sécurité des données de commandes, même si vos messages restent idéalement “ID + intention”.
RabbitMQ expose aussi des métriques (plugin Prometheus) indispensables pour surveiller messages_ready, messages_unacknowledged, taux de redelivery, et utilisation disque. Sans monitoring, vous allez découvrir la saturation via des symptômes applicatifs (timeouts, 503) — exactement les patterns décrits dans un contexte e‑commerce (voir KPI, paiements et prévention des 503).
Référence transport AMQP Symfony : https://symfony.com/doc/current/messenger.html#transport-configuration (et docs RabbitMQ : https://www.rabbitmq.com/documentation.html).
Redis (Streams) : quand la simplicité devient une contrainte
Redis comme transport Messenger (package symfony/redis-messenger) est attractif quand Redis est déjà dans l’architecture (cache/session/locks) : pas de broker supplémentaire, latence faible, ops simplifiée. Mais il faut être clair : vous utilisez Redis comme file, donc vous mélangez potentiellement des workloads (cache volatile + queue durable) sur le même cluster, ce qui augmente la criticité de Redis et la sensibilité aux évictions.
Le transport Redis de Symfony s’appuie sur Redis Streams (voir la documentation officielle : https://redis.io/docs/latest/develop/data-types/streams/). Concrètement, cela implique : un stream (ex. messenger), un consumer group, et des messages en pending entries list (PEL) tant qu’ils ne sont pas ack. La configuration expose des options qui comptent vraiment en prod : group, consumer, redeliver_timeout (temps avant revendication), claim_interval, et la stratégie de suppression après ack (pour éviter une croissance infinie du stream).
framework:
  messenger:
    transports:
      async:
        dsn: '%env(MESSENGER_REDIS_DSN)%' # redis://:pass@redis:6379
        options:
          stream: messenger
          group: app
          consumer: '%env(HOSTNAME)%'
          auto_setup: false
          delete_after_ack: true
          redeliver_timeout: 3600
          claim_interval: 60000
Le problème numéro 1 en production : la croissance mémoire si vous ne supprimez pas après ack, ou si vos consumers laissent des messages en PEL (workers tués, timeouts, pods évincés). Et contrairement à un broker dédié, Redis sert souvent déjà de composant “vital” (sessions, cache). Un incident classique :
- Redis est utilisé à la fois pour le cache PrestaShop et pour la queue Messenger.
- Pic de messages (import catalogue + sync stocks) + cache chaud.
- Pression mémoire →
maxmemoryatteint → évictions (evicted_keys) → comportement erratique côté cache. - Résultat visible : back‑office plus lent, TTFB en hausse, et parfois cascade d’erreurs côté PHP‑FPM.
Si vous voulez Redis pour les deux, séparez au minimum les bases/instances (et idéalement les clusters), et surveillez used_memory, evicted_keys, instantaneous_ops_per_sec, ainsi que la taille du stream et la PEL. Sur Redis en accélération applicative, voir aussi : OPcache, PHP‑FPM et Redis pour accélérer le back‑office.
Deux limites structurelles à accepter :
- Redis n’est pas RabbitMQ en termes de routing : vous compensez via plusieurs streams (par priorité ou domaine) ou via le routing Messenger (multiplication des transports).
- La durabilité dépend de votre politique AOF/RDB et de votre tolérance à la perte. Si votre queue est métier critique (facturation, stock), ne faites pas comme si Redis “cache” et Redis “queue” avaient la même exigence de persistance. Sur un Redis configuré avant tout “cache”, certains choix (éviction agressive, persistance faible) sont incompatibles avec une file durable.
Un réflexe utile : si un message a une valeur métier élevée, demandez-vous si vous accepteriez de le perdre lors d’un redémarrage Redis non planifié. Si la réponse est non, Redis Streams peut rester viable… mais uniquement avec une configuration et une exploitation cohérentes avec cet objectif.
Amazon SQS : file managée, contraintes de visibilité et design FIFO
SQS est souvent le choix “DevOps minimal” : pas de cluster RabbitMQ, pas de Redis critique à durcir, et une intégration IAM native. Le trade‑off est clair : vous rentrez dans le modèle SQS (visibility timeout, long polling, DLQ, limites de taille), et vous perdez les topologies de routing d’AMQP. Pour des workloads e‑commerce (sync, enrichissement, tâches batch), c’est souvent un très bon compromis, surtout si votre infra est déjà sur AWS.
Côté Symfony, DSN typique (idéalement sans clés statiques, en s’appuyant sur un rôle IAM / credentials chain) :
framework:
  messenger:
    transports:
      async:
        dsn: '%env(MESSENGER_SQS_DSN)%' # sqs://default/queue-name?region=eu-west-3
        options:
          wait_time: 20            # long polling
          visibility_timeout: 60   # seconds
          buffer_size: 10          # batch receive
Le paramètre le plus souvent mal réglé est visibility_timeout. Il doit être supérieur au temps de traitement max de votre handler (P99 + marge), sinon SQS va redélivrer le message pendant qu’un worker le traite encore, et vous créez des doublons “artificiels”. À l’inverse, trop grand => récupération lente en cas de crash.
Méthode simple (pragmatique) :
- mesurez la durée de traitement par type de message (logs + percentiles),
- fixez
visibility_timeout ≈ P99 + marge(par ex. +30%), - faites évoluer la valeur quand vous changez le code ou la charge.
Exemple : un handler de synchro Odoo (HTTP + DB + retries applicatifs) peut prendre 5–30 secondes. Mettre visibility_timeout=30 est fragile ; viser 60–120 secondes est souvent plus réaliste, et vous adaptez ensuite votre retry_strategy côté Symfony.
FIFO vs Standard : si vous avez besoin d’ordre strict par clé (ex. par order_id), SQS FIFO apporte l’ordering et une déduplication côté service (si vous renseignez les champs requis), mais le débit est plus contraint et il faut gérer message_group_id. Beaucoup de projets e‑commerce n’ont pas besoin de FIFO global ; ils ont besoin d’ordre local (par commande, par produit). Dans ce cas, regrouper par identifiant (message_group_id=order-123) limite les effets de concurrence tout en gardant du parallélisme sur d’autres commandes.
Enfin, n’oubliez pas les limites “physiques” : 256 KB/message (donc pas d’exports), et coûts associés aux appels (receive/delete). Un design propre “message = ID + intent” réduit à la fois les coûts et les incidents.
Référence AWS SQS Developer Guide (DLQ, visibilité, long polling) : https://docs.aws.amazon.com/AWSSimpleQueueService/latest/SQSDeveloperGuide/welcome.html. (Et si votre contrainte est la résidence des données, notez que l’exemple eu-west-3 correspond à la région Paris, souvent choisie pour des besoins UE.)
Exploitation : workers, scaling, observabilité, et cas PrestaShop
Un transport bien configuré ne sert à rien si vos workers sont gérés “à la main”. En production, vous devez définir (1) un process manager (systemd, supervisord, Kubernetes), (2) des limites (--time-limit, --memory-limit), (3) un modèle de déploiement (rolling restart des workers), et (4) une stratégie de drain (arrêt propre). Exemple de commande pragmatique :
php bin/console messenger:consume async -vv \
  --time-limit=3600 \
  --memory-limit=256M \
  --sleep=1
Deux pratiques qui évitent beaucoup de dette opérationnelle :
- Redémarrages réguliers : même avec un code propre, les workers longs finissent par accumuler de la mémoire (clients HTTP, buffers, caches in‑process). Un
--time-limitraisonnable + redémarrage orchestré est une “ceinture de sécurité”. - Segmentation par priorité : en e‑commerce, certaines tâches ne doivent pas ralentir les autres (ex. sync stocks vs envoi emails). Prévoir plusieurs transports (
async_high,async_low) vous permet de scale différemment et de limiter l’effet “file unique = goulot”.
Côté capacité, raisonnez avec des ordres de grandeur mesurables. Si un handler prend 200 ms en moyenne et 1 seconde au P95, un worker séquentiel traite ~5 msg/s en moyenne, mais sature vite si les messages “lents” dominent. Vous scalez horizontalement (N workers) et vous imposez une limite de concurrence “effective” via prefetch_count (RabbitMQ) ou via le nombre de pods. Si vous avez un doute sur ce qui est réellement lent (SQL, HTTP, sérialisation), profilez avant d’ajouter des workers (voir la méthodo audit de performance PHP/Symfony avec profilage).
L’observabilité n’est pas optionnelle. Minimum syndical :
- logs structurés avec
message_class,message_id(stamp),transport,handler,duration_ms,retry_count, et uncorrelation_idpropagé depuis la requête HTTP qui a dispatché le message ; - métriques : messages consommés/min, messages en échec, temps de traitement (moyenne + P95/P99), backlog (taille de queue/stream), et taux de redelivery ;
- alertes orientées business : backlog qui monte et qui ne redescend pas, hausse du taux d’échec sur un handler critique (paiement, stock), et saturation (CPU/RAM workers, disque RabbitMQ, mémoire Redis).
Sans ça, vous allez “découvrir” une panne quand le backlog devient un incident business (commandes non synchronisées, stocks obsolètes, retours marketplace en erreur). Les patterns de télémétrie décrits pour les webhooks (latence, taux d’échec, health checks) s’appliquent 1:1 aux consumers (voir télémétrie & santé des intégrations).
Spécifique PrestaShop : le cœur n’est pas pensé nativement comme une app “workers first”. Si vous implémentez Messenger dans un module, gardez ces contraintes en tête :
- (a) compatibilité Symfony (PrestaShop 9 s’aligne sur Symfony 6.4, donc évitez d’introduire une version majeure discordante via le
vendor/du module), - (b) éviter les traitements longs dans les hooks front/back (sinon 503 et dégradation UX),
- (c) externaliser les appels réseau (ERP, PIM, marketplaces) en messages async,
- (d) prévoir une stratégie de reprise : un backlog doit être “rattrapable” après incident, sans créer de doublons dangereux.
Sur les problématiques compatibilité Symfony/modules, vous avez déjà un cadre utile ici : compatibilité Symfony 6.4 et Admin API dans les modules.
Pour finir, si votre architecture e‑commerce utilise déjà Redis pour cache (voire sessions), réfléchissez à la séparation des responsabilités plutôt qu’à l’empilement. Une stratégie cache/infra 2026 avec Redis/Varnish/CDN ne se gère pas comme une file de messages durable (voir stratégie cache PrestaShop : OPcache, Redis, Varnish, CDN). En pratique : SQS pour la queue “métier critique” managée, RabbitMQ si vous avez besoin de routing/contrôle fin, Redis Streams si vous assumez la contrainte mémoire et la persistance, et que l’exploitation Redis est déjà maîtrisée.